La transcripción es el proceso de
síntesis de RNA a partir de DNA. Sigue el mismo principio de apareamiento de bases que la replicación del DNA, pero se reemplaza la
timina por el uracilo. En cada transcripción, sólo una de las cadenas del DNA se transcribe. La RNA polimerasa cataliza la adición de ribonucleótidos al extremo 3´ de la cadena de RNA, de modo que esta última es antiparalela a la
cadena molde de DNA.
Transcripción del DNA
En la región del promotor, punto de unión de la enzima RNA polimerasa, la doble hélice de DNA se abre y, a medida que la RNA polimerasa avanza a lo largo de la molécula de DNA, se separan las dos cadenas. Los ribonucleótidos, que constituyen los bloques estructurales, se ensamblan en la dirección 5' a 3' a medida que la enzima lee la cadena molde de DNA. Nótese que la cadena de RNA recién sintetizada es complementaria, no idéntica, a la cadena molde a partir de la cual se transcribe; su secuencia, sin embargo, es idéntica a la cadena codificante de DNA (no transcrita), excepto por un detalle: en el RNA, la timina (T) se reemplaza por uracilo (U). El RNA recién sintetizado se separa de la cadena molde de DNA.
La RNA polimerasa no necesita un cebador para iniciar la síntesis. Se une al DNA en una secuencia específica, el promotor, que define el punto de inicio de la transcripción y su dirección.
En los procariontes, el proceso de transcripción continúa hasta que la polimerasa encuentra una secuencia que constituye la
señal de terminación. En los eucariontes, el proceso termina cuando el RNA es cortado en una secuencia específica. Al finalizar la transcripción, la RNA polimerasa se detiene y libera la cadena molde de DNA y el mRNA sintetizado.
En los eucariontes, los transcritos primarios sufren diversas modificaciones durante la transcripción. Entre ellas se encuentran la adición del CAP, la poliadenilación y el
splicing. Este último proceso consiste en el corte y la eliminación de ciertas secuencias, los intrones, y el posterior empalme de las secuencias restantes, los exones. Sólo los exones forman parte del mRNA maduro. Un mismo transcrito primario puede ser procesado por
splicing de distintas maneras. Este
empalme alternativo permite que una molécula de mRNA inmadura pueda originar diferentes moléculas de mRNA maduro.
Procesamiento del mRNA en eucariontes
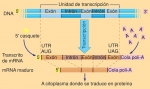
La información genética codificada en el DNA se transcribe a una copia de RNA (transcripto primario). Esta copia se modifica en forma cotranscripcional con la adición del casquete 5' (CAP), el corte de los intrones y el empalme de los exones (splicing
) y, finalmente con la adición de la cola de poliA. A ambos extremos del mensajero hay secuencias no traducibles, denominadas extremos 5´UTR (región no traducible que abarca desde el CAP hasta el codón de iniciación) y extremos 3´UTR (región no traducible que abarca desde el codón de terminación hasta la cola de PoliA). En esta figura, el splicing
se produce luego de la adición de la cola de poli-A, sin embargo, muchas veces el proceso de corte y empalme ocurre antes de que haya concluido la transcripción. El mRNA maduro luego se dirige al citoplasma, donde se traduce a proteínas.
En el ciliado de agua dulce
Tetrahymena, el
intrón inmaduro actúa como
catalizador de la escisión, produciendo un empalme autocatalítico. A este RNA con función de enzima se lo llama ribozima.
La traducción: del RNA al polipéptido
La traducción es la conversión de la secuencia de nucleótidos del RNA en la secuencia de aminoácidos de un polipéptido. En este proceso participan los mRNA, los RNA ribosómicos (
rRNA) y los
RNA de transferencia (
tRNA).
Los ribosomas están formados por rRNA y proteínas. Cada uno está formado por dos subunidades de diferente tamaño que, además, en los procariontes son más pequeñas que en los eucariontes.
El mRNA y el tRNA iniciador se unen a la subunidad ribosómica menor. Luego se les une la subunidad mayor y cataliza la unión peptídica entre aminoácidos. En la subunidad mayor existen tres sitios a los que se une el tRNA: el sitio A (aminoacílico), el sitio P (peptidílico) y el sitio E (de salida).
Los tRNA son moléculas pequeñas, con una estructura secundaria semejante a la hoja de un trébol, que presentan dos sitios de unión. Uno de ellos es el
anticodón, que se aparea con el codón del mRNA. El otro sitio, ubicado en el extremo 3´, se acopla a un aminoácido particular en forma muy específica. Así, los tRNA permiten la alineación de los aminoácidos de acuerdo con la secuencia de nucleótidos del mRNA.
El grupo de enzimas aminoacil-tRNA sintetasas catalizan la unión entre el aminoácido y el tRNA y forman el complejo aminoacil-tRNA. Este complejo se une a la molécula de mRNA, apareando el anticodón con el codón del mRNA en forma antiparalela. Así, el tRNA coloca al aminoácido específico en su lugar. El enlace entre el aminoácido y el tRNA se rompe cuando se forma el enlace entre el aminoácido recién llegado y el último de la cadena polipeptídica en crecimiento.
En los procariontes, el proceso de traducción comienza antes de que haya finalizado el de transcripción. En los eucariontes, ambos procesos están separados en el tiempo y en el espacio: la transcripción ocurre en el
núcleo y la traducción, en el citoplasma.
Tanto en procariontes como en eucariontes, la síntesis de polipéptidos ocurre en tres etapas: iniciación, elongación y terminación.
Hacia el final del mRNA hay un codón que actúa como señal de terminación. No existe ningún tRNA que tenga un anticodón que se aparee con este codón. Existen, en cambio, factores de liberación que se unen al codón de terminación y provocan la separación del polipéptido y el tRNA. Finalmente, las dos subunidades ribosómicas también se separan.